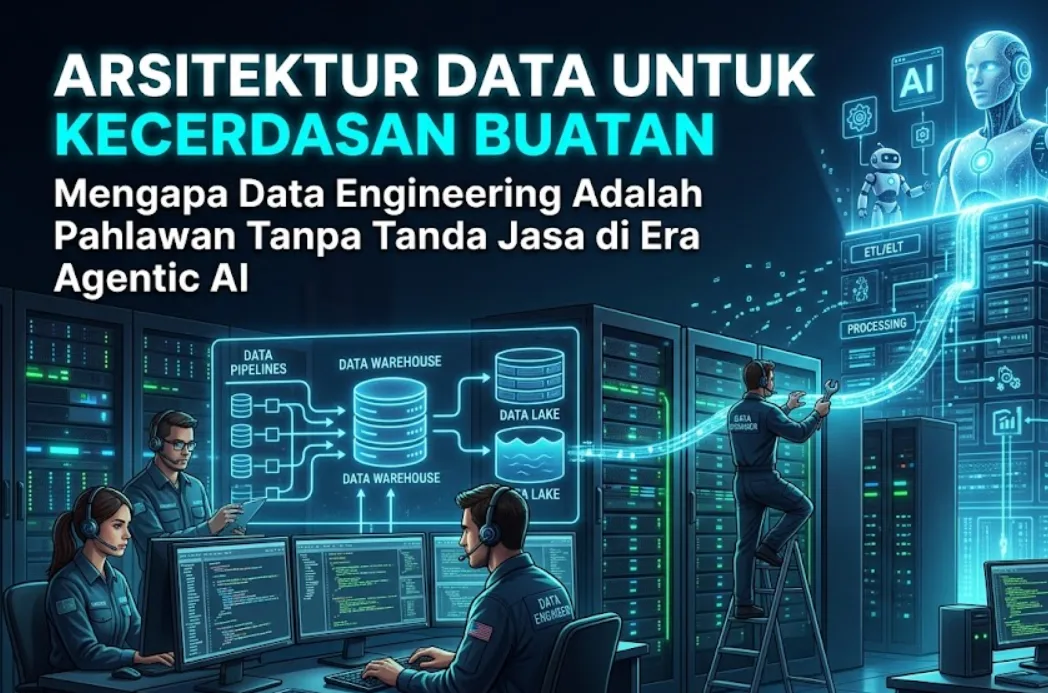
Arsitektur Data untuk Kecerdasan Buatan: Mengapa Data Engineering Adalah Pahlawan Tanpa Tanda Jasa di Era Agentic AI
 Gambar Dibuat AI
Kita sering banget denger kalau model terbaru kayak Gemini atau Claude itu sakti banget. Tapi, kenyataannya pas kita terapin di bisnis sendiri, hasilnya sering gak sesuai ekspektasi. Masalahnya biasanya bukan di modelnya, tapi di "makanan" yang kita kasih ke dia.
Banyak orang terlalu fokus sama algoritma tapi lali kalau pondasi utamanya adalah data. Tanpa arsitektur data yang bener, AI kamu cuma bakal jadi mesin halusinasi yang canggih.
Wes wayae kita bahas gimana cara ngebangun jalur data yang bener-bener solid buat sistem Agent kamu.
Prinsip dasarnya simpel: Garbage In, Garbage Out. Kalau data yang kamu masukin ke sistem RAG itu sampah, ya hasilnya bakalan kacau. Tapi ngebersihin data buat AI itu beda jauh sama ngebersihin data buat database SQL biasa.
Kita gak cuma ngomongin soal baris dan kolom, tapi soal semantik, konteks, dan keterkaitan antar informasi yang sering kali tersembunyi. Di sinilah peran Data Engineering buat AI jadi sangat krusial. Kita butuh pipeline yang gak cuma mindahin data, tapi juga "memahami" data itu sebelum disodorin ke si Agent.
1. Strategi Chunking: Seni Memotong Informasi Tanpa Kehilangan Makna
Pas kita ngomongin RAG (Retrieval-Augmented Generation), salah satu langkah paling teknis dan sering disepelein adalah chunking. Kebanyakan pemula cuma asal potong dokumen per 500 karakter.
Padahal, kalau kamu asal potong pas di tengah-tengah kalimat yang penting, AI bakalan kehilangan konteksnya. Iki sing marahi AI sering salah paham pas kita tanya soal kebijakan yang detil.
Ada beberapa teknik chunking yang lebih pro. Pertama adalah Semantic Chunking. Bukannya motong berdasarkan jumlah karakter, kita motong berdasarkan perubahan topik.
Kita pake model embedding kecil buat ngetes apakah kalimat selanjutnya masih nyambung sama kalimat sebelumnya. Kalau bedanya wes adoh, baru kita potong jadi chunk baru. Cara ini mastiin setiap potongan informasi yang masuk ke Vector Database itu utuh dan punya makna yang kuat.
Selain itu, kita juga perlu mikirin soal "Overlap". Kita kasih sedikit potongan dari chunk sebelumnya ke chunk setelahnya. Tujuannya biar ada jembatan informasi. Jadi pas AI baca satu potongan, dia masih punya sedikit bayangan soal konteks sebelum dan sesudahnya.
Ini krusial banget buat dokumen teknis yang isinya instruksi berantai. Tanpa overlap yang pas, Agent kamu bakalan kayak orang linglung yang cuma paham sepotong-sepotong.
2. Hybrid Search: Gabungan Kekuatan Kata Kunci dan Makna
Banyak yang mikir kalau Vector Search (Semantic Search) itu segalanya. Emang bener, Vector Search pinter nyari sesuatu yang maknanya mirip. Tapi, dia sering gagal pas kita nyari istilah teknis yang spesifik banget, kode produk, atau nama orang yang unik.
Di sini kita butuh yang namanya Hybrid Search. Kita gabungin kekuatan Vector Search sama Keyword Search tradisional (kayak BM25).
Kenapa ini penting? Karena kadang kita butuh presisi eksak. Misal kamu nyari dokumen soal "Printer XJ-900". Vector Search mungkin bakal ngasih dokumen soal printer secara umum karena maknanya mirip.
Tapi dengan Keyword Search, sistem bakalan mastiin kalau dokumen yang ada tulisan "XJ-900" itu yang muncul di urutan paling atas. Teknik ini bikin Agent kamu jadi jauh lebih akurat dan gak gampang kena tipu sama sinonim yang gak relevan. Pancen kudu teliti pas nyusun bagian ini biar hasilnya maksimal.
3. Metadata Filtering: Memberi Navigasi pada Lautan Vektor
Bayangin kamu punya jutaan chunk di database. Pas kamu nanya sesuatu, AI harus nyari di antara jutaan data itu. Meskipun Vector Database itu cepet, tapi kalau pencariannya terlalu luas, kemungkinan dapet data "sampah" itu makin gede.
Solusinya adalah Metadata Filtering. Kita jangan cuma simpen teksnya doang, tapi kita kasih label atau tag di setiap potongan data itu.
Misal, kita kasih tag soal kapan dokumen itu dibuat, siapa penulisnya, atau kategori departemennya. Jadi pas kita tanya, "Apa kebijakan cuti tahun 2026?", Agent secara otomatis bakal nge-filter: "Cari cuma di kategori HR dan tahun 2026".
Ini bakal memangkas ruang pencarian secara drastis. Hasilnya? AI jadi lebih cepet, lebih murah karena token yang kepake dikit, dan pastinya jauh lebih akurat. Gak bakal ada lagi cerita AI ngasih info jadul tahun 2020 buat pertanyaan tahun 2026.
4. Cold Start Problem dan Dynamic Data Ingestion
Satu tantangan besar di industri adalah data yang berubah tiap detik. Kalau kamu cuma lakuin indexing sekali sebulan, Agent kamu bakalan ketinggalan info. Kita butuh pipeline data yang sifatnya real-time atau mendekati real-time.
Tekniknya adalah pake Change Data Capture (CDC). Begitu ada perubahan di database utama atau ada file baru di cloud storage, sistem otomatis bakal ngelakuin embedding dan update ke Vector Database.
Masalahnya, proses embedding itu butuh biaya dan waktu. Kita gak bisa tiap detik update jutaan data. Makanya kita butuh strategi caching yang pinter. Data yang sering diakses ditaruh di memori yang cepet, sementara data lama tetep di database.
Iki pancen tantangan teknis sing butuh pemahaman soal infrastruktur cloud yang mendalam. Tapi kalau wes dadi, sistem kamu bakal ngerasa bener-bener "live" dan selalu update sama kondisi lapangan terbaru.
5. Evaluasi Pipeline dengan RAGAS dan Trulens
Gimana kita tahu kalau pipeline data kita sudah bagus? Kita gak bisa cuma ngetes pake perasaan. Kita butuh metrik yang jelas. Di dunia pro, kita pake framework kayak RAGAS buat ngukur beberapa hal penting.
Pertama adalah Faithfulness, yaitu seberapa setia jawaban AI sama data yang dikasih. Kedua adalah Answer Relevance, seberapa nyambung jawabannya sama pertanyaan. Dan yang ketiga adalah Context Precision, seberapa tepat potongan data yang diambil sama sistem retrieval kita.
Dengan metrik ini, kita bisa ngelakuin eksperimen secara ilmiah. Misal, "Kalau chunk size tak ubah jadi 1000, skor Faithfulness-nya naik apa turun?". Tanpa evaluasi yang terukur kayak gini, ngebangun AI cuma bakal kayak nebak-nebak buah manggis.
Kamu bakal terjebak dalam siklus trial and error yang gak ada ujungnya. Evaluasi ini mestinya ditaruh di dalam sistem CI/CD kamu, jadi tiap ada perubahan kode, sistem otomatis ngetes kualitas jawabannya.
6. Synthetic Data Generation untuk Edge Cases
Kadang kita punya masalah: datanya dikit banget atau ada skenario yang jarang terjadi tapi penting (edge cases). Buat ngelatih Agent biar jago di situasi sulit ini, kita bisa pake teknik Synthetic Data Generation.
Kita suruh model yang lebih pinter kayak Gemini 1.5 Pro buat bikin variasi pertanyaan dan jawaban berdasarkan data yang dikit tadi. Data buatan ini terus kita pake buat nge-fine-tune model yang lebih kecil atau buat ngetes ketahanan pipeline kita.
Teknik ini sakjane ampuh banget buat ngisi kekosongan informasi. Tapi kudu ati-ati, jangan sampai data buatan ini malah ngeracuni logika asli si AI. Kita tetep butuh verifikasi manusia di beberapa sampel buat mastiin kualitasnya.
Kalau dipake dengan bener, data sintetik ini bisa bikin Agent kamu punya pengalaman "virtual" yang luas meskipun data aslinya terbatas banget. Ini salah satu rahasia gimana perusahaan besar bisa punya AI yang pinter banget di bidang yang sangat spesifik.
7. Data Governance dan Keamanan Privasi
Iki bagian sing paling sensitif tapi sering dilali. Pas kita nyuapin data ke AI, kita harus mastiin gak ada data pribadi (PII) yang ikut masuk ke server pihak ketiga kalau kita pake API publik.
Kita butuh layer PII Masking di pipeline kita. Sebelum data di-embed, sistem harus otomatis nyensor nama, alamat, atau nomor telepon. Keamanan data pelanggan itu harga mati, gak bisa ditawar-tawar lagi.
Selain itu, kita juga harus mikirin soal Access Control di level RAG. Jangan sampai karyawan magang bisa nanya ke AI soal rahasia gaji direktur cuma gara-gara dokumennya ada di database yang sama. Kita kudu nerapin sistem di mana Agent cuma bisa "ngambil" data yang emang boleh diakses sama user yang nanya.
Ini teknisnya lumayan njelimet karena kita harus nyimpen informasi izin akses (ACL) di dalem metadata setiap chunk data. Tapi ini wajib dilakuin kalau kamu mau AI-mu dipake di level perusahaan besar.
8. Menghadapi Data Multimodal: Gambar dan Audio
Di masa depan, data bukan cuma teks. Agent kamu mungkin harus baca gambar skema mesin, dengerin rekaman meeting, atau nonton video tutorial. Arsitektur data kita harus siap buat Multimodal RAG. Kita gak cuma simpen teks, tapi kita simpen representasi visual dari gambar itu dalam bentuk vektor yang sama.
Jadi pas kamu tanya, "Mana bagian mesin yang rusak?", AI bisa nyari di database gambar dan nemuin foto yang relevan.
Proses ini butuh model embedding yang lebih canggih kayak CLIP atau model vision-language lainnya. Tantangannya adalah gimana cara nyelarasin antara makna teks dan makna gambar dalam satu ruang koordinat yang sama. Iki teknologi sing lagi kembang banget sekarang. Kalau kamu bisa nerapin ini, Agent kamu bakal punya tingkat "kesadaran" yang jauh lebih tinggi dibanding AI yang cuma bisa baca teks doang. Proyekmu bakalan dadi jauh lebih kompetitif di pasar.
9. Debugging Arsitektur Agent yang Kompleks
Pas sistem kamu makin gede, nyari error di AI itu susahnya minta ampun. Kita butuh sistem Tracing yang detil. Kita harus bisa liat aliran pikir si Agent: "Dia dapet pertanyaan apa, dia nyari ke database mana, dapet potongan teks apa, terus kenapa dia nyimpulne jawaban kayak gitu?". Tools kayak LangSmith atau Phoenix itu penting banget buat ngintip isi kepala AI pas lagi kerja.
Seringkali masalahnya sepele, misal AI salah ngambil dokumen gara-gara ada kata yang mirip tapi konteksnya beda. Dengan tracing, kita bisa benerin sistem retrieval kita tanpa harus bongkar seluruh kodingan.
Kita jadi tahu titik mana yang lemah, apakah di bagian pengambil data (retrieval) atau di bagian penyusunan jawaban (generation). Debugging yang sistematis bakal ngebantu kamu ngebangun kepercayaan user ke AI yang kamu buat
10. Perjalanan Menjadi Data-Centric AI Architect
Ngebangun Agent AI yang handal itu marathon, dudu sprint. Kuncinya bukan di seberapa mahal model yang kamu sewa, tapi seberapa rapi dan pinter kamu ngelola data yang masuk ke sistem itu.
Dari chunking yang presisi, metadata yang detail, sampai keamanan yang ketat, semua itu adalah satu kesatuan yang gak bisa dipisahkan. Tanpa data engineering yang kuat, AI kamu cuma bakal jadi pajangan yang indah tapi gak fungsional.
Dunia teknologi bakal terus berubah, model-model baru bakal muncul tiap minggu, tapi prinsip pengolahan data yang bener bakal tetep relevan. Jadi, fokuslah ngebangun aset data yang bersih dan terstruktur.
Kalau pondasinya wes kuat, mau diganti model apa pun di atasnya, sistem kamu bakalan tetep tangguh dan pinter. Wes wayae kamu berhenti cuma jadi tukang ngetik prompt dan mulai jadi arsitek sistem kecerdasan yang sebenernya.
gak usah wedi gagal, sing penting terus eksplorasi dan perbaiki sistemnya pelan-pelan sampai bener-bener dadi sistem sing sempurna.
Semoga pembahasan yang cukup panjang dan detil ini bisa ngasih gambaran baru soal apa yang sebenernya kurang dari sistem AI yang kamu kembangin sekarang.
Fokus ke data, kuasai pipeline-nya, dan liat gimana Agent kamu bertransformasi jadi asisten yang bener-bener jenius. Selamat berkarya dan teruslah ngebangun masa depan yang lebih cerdas dengan teknologi AI yang tepat guna.